12 minutes
KubeHive II - Terraform
Parte 2: El primer nodo de KubeHive lo monté a mano en la VPS Vultr. Tiene sus ventajas, lo puedes debuguear tranquilamente, cambiar configuraciones, probar cosas nuevas, pero si queria otra dirección IP tenia que crear otra VM e instalar todo desde 0. Habia oido hablar de Terraform, e indagando un poco descubrí cloud-init. Con estos dos amigos descubrí que podia desplegar todas las maquinas que quisiera teniendo todas la misma configuración con tan solo
terraform apply. Y mejor aun, unirlas a mi proyecto!
Presentación
En el post KubeHive monté la infraestructura base: un cluster de Kubernetes con un master, un worker en una VPS (Vultr), honeypots corriendo en este nodo con OpenCanary y Mailoney, y enviando todos los registros a un stack ELK.
El proyecto inició con el planteamiento de la rotación de direcciones IP para que los “malos” no detectaran que estaban en una trampa. Queria evitar a toda costa que los datos que obtuviera se convirtieran en ruido o directamente no hubiera. Como las direcciones IP las otorga la VPS de manera aleatoria según la region en la que esté la maquina virtual la mejor opcion era hacer estas máquinas volátiles, es decir eliminar y crear una desde 0 con otro tipo de honeypot (o el mismo) para que tenga otra dirección IP.
Hacerlo a mano cada vez que tuviera que rotar era una locura. Conectarse por SSH, instalar dependencias, configurar WireGuard, ejecutar el join de kubeadm, etiquetar el nodo… Todo esto por cada rotación es inviable.
Planteamiento
Antes que nada tengo que tener claro que voy a automatizar. Separo lo que es igual en todos los nodos y lo que cambia. Desplegaré tres nodos como PoC.
Lo que es estático
- Instalación de paquetes (containerd, kubelet, kubeadm, kubectl, filebeat, wireguard)
- Configuración de containerd con SystemdCgroup = true
- Parámetros de kernel y sysctl (br_netfilter, ip_forward)
- Reglas de iptables (firewall)
- filebeat.yml (todos apuntan al mismo Elasticsearch en 10.10.10.10)
Lo que es dinámico
- IP de WireGuard del nodo en el túnel (Una por nodo)
- Clave privada de WireGuard de ese nodo
- Token de kubeadm join (se genera cada vez que desplegamos)
- Label del nodo para el nodeSelector de los pods
Los tres nodos planificados:
| Nodo | Zona | IP túnel WG |
|---|---|---|
| KubeHive-R2D2 | París (cdg) | 10.10.20.4 |
| KubeHive-SIRIUS | Silicon Valley (sjc) | 10.10.20.5 |
| KubeHive-Vader | México (mex) | 10.10.20.6 |
Tres regiones, tres IPs públicas distintas, tres perspectivas de ataque diferentes.
Los atacantes de Asia llegan antes a Silicon Valley.
Los de Latinoamérica a México.
Los europeos a París.
Toda la gestion centralizada en Kubernetes y recogida en ELK.
El problema de la rotación manual
Cuando monté el primer nodo a mano, el proceso fue el siguiente:
- Crear el VPS en Vultr
- Instalar paquetes
- Configurar WireGuard y su interfaz
- Esperar a que el túnel levantara y comprobar en mikrotik
- Ejecutar el kubeadm join
- Etiquetar el nodo
- Configurar Filebeat
- Desplegar los honeypots desde el nodo Master
Entre lecturas instalaciones y comprobaciones tarde algo más de media hora. Contando con el margen de error humano por supuesto. El token de kubeadm caduca en 24 horas, así que tienes margen para equivocarte bastante, sin embargo debuguear la conexion de WG esimportante ya que necesita que el peer esté configurado en el hEX S antes de que el nodo intente conectar.
Y más importante aun, saber a que redes y que accesos van a tener los nodos externos ya que se tienen que poder conectar al Master que está en otra red.
Si en el futuro quieres tener seis nodos en vez de tres, la cosa a mano escala fatal. Esto lo arregla Terraform con el modelo IaC (Infraestructura como código).
Terraform: infraestructura como código
Terraform describe lo que quieres que exista. Si no existe, lo crea. Si ya existe y se ha modificado, lo actualiza. Si le dices que lo destruya, lo destruye. El estado de la infraestructura vive en un fichero terraform.tfstate que guarda todos los cambios y estados requeridos.
La estructura del proyecto:
~/kubehive/terraform/
  ├── main.tf          → recursos Vultr y lógica principal
  ├── variables.tf     → declaración de variables con tipos
  ├── terraform.tf     → versión de Terraform y providers
  ├── terraform.tfvars → valores reales (nunca a git)
  ├── outputs.tf       → IPs de los nodos al terminar
  ├── cloud-init.yaml  → template del cloud-init por nodo
  └── iptables.sh      → script de firewall
El main.tf tiene tres partes clave.
Token Kubeadm: El token de union al cluster de Kubernetes se genera y normalmente tiene una validez de 24h, se puede crear con un tiempo indefinido pero si se compromete tienes un BUEN problema. Lo apañamos con este bloque de Terraform que llama la Master durante la ejecución y genera un token nuevo con un TTL de 1 hora.
Nota: indicamos el valor “external” para que la ejecución del comando se realice en local, este provider se define en terraform.tf
data "external" "kubeadm_join" {
  program = ["bash", "-c", <<-EOT
    TOKEN=$(kubeadm token create --ttl 1h 2>/dev/null)
    HASH=$(openssl x509 -pubkey -in /etc/kubernetes/pki/ca.crt | \
           openssl rsa -pubin -outform der 2>/dev/null | \
           openssl dgst -sha256 -hex | sed 's/^.* //')
    echo "{\"token\": \"$TOKEN\", \"hash\": \"sha256:$HASH\"}"
  EOT
  ]
}
El token se crea durante el apply, se usa en el join y caduca.
Definición de Nodos: un bloque de recurso con un bucle for_each recorre y crea los tres nodos en sus respectivas regiones con las configuraciones respectivas. Primero definimos el nombre y region (locals-servers) y luego los recuros (resource-plan-region…)
locals {
  servers = {
    paris   = { region = "cdg", label = "KubeHive-R2D2" }
    svalley = { region = "sjc", label = "KubeHive-SIRIUS" }
    mexico  = { region = "mex", label = "KubeHive-Vader" }
  }
}

resource "vultr_instance" "honeypots" {
  for_each  = local.servers
  plan      = "vc2-1c-1gb"
  os_id     = 1743
  region    = each.value.region
  label     = each.value.label
  hostname  = each.value.label
  user_data = local.user_data_config[each.key]
}
El templatefile por nodo: cada nodo recibe su propio cloud-init con sus variables asignadas en terraform.tfvars.
user_data_config = {
  for key, server in local.servers :
  key => templatefile("${path.module}/cloud-init.yaml", {
    script_content     = indent(6, file("${path.module}/iptables.sh"))
    wg_private_key     = var.wg_keys[key].private_key
    wg_ip              = var.wg_keys[key].wg_ip
    wg_server_pubkey   = var.wg_server_pubkey
    wg_server_endpoint = var.wg_server_endpoint
    kubeadm_token      = data.external.kubeadm_join.result.token
    kubeadm_hash       = data.external.kubeadm_join.result.hash
    node_label         = server.label
    filebeat_password  = var.filebeat_password
    filebeat_ca_cert_b64 = var.filebeat_ca_cert_b64
  })
}
París recibe la clave privada de París y la IP 10.10.20.4.
Silicon Valley la suya y la 10.10.20.5.
México lo mismo. Mismo template, tres nodos distintos.
Cloud-init: comandos para configuración automática.
Cloud-init es el mecanismo que ejecuta un script de configuración la primera vez que arranca un servidor. Vultr lo soporta de forma nativa: pasas el cloud-init como user_data al crear el VPS y se ejecuta automáticamente.
El cloud-init hace todo lo que antes se hacía a mano, en orden y sin intervención humana, instalación de paquetes, configuración, preparacion y union al cluster k8s.
#cloud-config
package_update: true
package_upgrade: true

write_files:
  # Módulos necesarios para k8s
  - path: /etc/modules-load.d/k8s.conf
    content: |
      overlay
      br_netfilter

  # Parámetros de red
  - path: /etc/sysctl.d/k8s.conf
    content: |
      net.bridge.bridge-nf-call-iptables  = 1
      net.bridge.bridge-nf-call-ip6tables = 1
      net.ipv4.ip_forward                 = 1

  # WireGuard con variables por nodo
  - path: /etc/wireguard/KubeHive.conf
    permissions: '0600'
    content: |
      [Interface]
      PrivateKey = ${wg_private_key}
      Address = ${wg_ip}/24

      [Peer]
      PublicKey = ${wg_server_pubkey}
      Endpoint = ${wg_server_endpoint}
      AllowedIPs = 10.10.20.0/24, 10.10.10.0/24
      PersistentKeepalive = 25

  #La variable de Filebeat necesita doble $ y doble % para escapar las variables
  - path: /etc/filebeat/filebeat.yml
    content: |
      filebeat.inputs:
        - type: log
          paths: [/var/log/opencanary/opencanary.log]
          fields: {honeypot: opencanary}
          json.keys_under_root: true
        - type: log
          paths: [/var/log/mailoney/commands.log]
          fields: {honeypot: mailoney}
          json.keys_under_root: true
      output.elasticsearch:
        hosts: ["https://10.10.10.10:9200"]
        username: "filebeat_honeypot"
        password: "$${ES_PASSWORD}"
        ssl.certificate_authorities: ["/etc/filebeat/http_ca.crt"]
        index: "honeypot-%%{+yyyy.MM.dd}"
      setup.ilm.enabled: false
      setup.template.name: "honeypot"
      setup.template.pattern: "honeypot-*"
Nota: el $$ en $${ES_PASSWORD} y el %% en %%{+yyyy.MM.dd}. Terraform usa ${} y %{} como su propia sintaxis de template. Si no se escapan, Terraform los interpreta como sus variables y fallará. Con doble símbolo le dices a Terraform que los deje pasar tal cual al fichero final donde ahí si actuarán como variables.
El certificado CA de Elasticsearch tiene otro problema: es un fichero multilinea y meterlo en un YAML rompe el parser de cloud-init. La solución es introducirlo en base64. Se codifica en el master, se pasa como variable de una sola línea en terraform.tfvars y se decodifica en el runcmd.
En el master-> base64 -w 0 /etc/elasticsearch/certs/http_ca.crt » ~/terraform/terraform.tfvars
  # En cada worker se ejecuta a traves de cloud-init.
  - echo "${filebeat_ca_cert_b64}" | base64 -d > /etc/filebeat/http_ca.crt
Conexion WireGuard
Las claves se generan e introducen en mikrotik de manera manual. El control de acceso es necesario que se gestione manualmente, es una tarea con poca carga y asequible a la hora de unir nodos a un cluster. Te da control sobre los nodos que van a traves de la VPN evitando invitados indeseados.
Cada nodo necesita su propio par de claves WireGuard. Se generan en el master antes del apply y se añaden manualmente como peers en el hEX S y como variables en el tfvars:
# París
wg genkey | tee /tmp/paris_private.key | wg pubkey > /tmp/paris_public.key

# Silicon Valley
wg genkey | tee /tmp/svalley_private.key | wg pubkey > /tmp/svalley_public.key

# México
wg genkey | tee /tmp/mexico_private.key | wg pubkey > /tmp/mexico_public.key
Las claves públicas van al hEX S como nuevos peers en WinBox. Las privadas van al terraform.tfvars marcadas como sensitive:
wg_keys = {
  paris = {
    private_key = "<clave_privada_paris>"
    wg_ip       = "10.10.20.4"
  }
  svalley = {
    private_key = "<clave_privada_svalley>"
    wg_ip       = "10.10.20.5"
  }
  mexico = {
    private_key = "<clave_privada_mexico>"
    wg_ip       = "10.10.20.6"
  }
}
Terraform nunca muestra variables sensitive en los logs ni en el plan. El tfvars nunca va a git.
El fichero terraform.tfvars tendrá el siguiente aspecto:
vultr_api_key = "XXXXXXXXXXX"
filebeat_password = "XXXXXXX"
filebeat_ca_cert_b64 = "LS0tLS1CRUdJTiBDRVJUSUZJQ0........"

wg_server_pubkey   = "XXXXXXX" #pubkey WG MKT hEx
wg_server_endpoint = "X.X.X.X:51820"

wg_keys = {
  paris = {
    private_key = "XXXXXXX" #private wg
    wg_ip       = "10.10.20.4"
  }
  svalley = {
    private_key = "XXXXXXX" #private wg
    wg_ip       = "10.10.20.5"
  }
  mexico = {
    private_key = "XXXXXXX" #private wg
    wg_ip       = "10.10.20.6"
  }
}
Y por ultimo la declaración de las variables y su caracter sensible o natural en variables.tf:
variable "vultr_api_key" {
  type      = string
  sensitive = true
}

variable "filebeat_password" {
  type      = string
  sensitive = true
}

variable "filebeat_ca_cert_b64" {
  type = string
}

variable "wg_keys" {
  type = map(object({
    private_key = string
    wg_ip       = string
  }))
  sensitive = true
}

variable "wg_server_pubkey" {
  type        = string
  description = "Clave publica WireGuard - hEX S"
}

variable "wg_server_endpoint" {
  type        = string
  description = "IP publica master:puerto WireGuard"
}
El join automático al cluster
El objetivo final de esta automatización es la union de un nuevo nodo al cluster. Para que se una sin problema tiene que estar bien configurado, es importante el orden de ejecución. Primero se instalan los paquetes, luego se establece la conexion interna con Wireguard y una vez este el tunel levantado y la conexion establecida ya podremos unir el nodo.
Siguiendo este orden el apartado runcmd de cloud-init quedará de la siguiente manera:
runcmd:
  # ... instalación de paquetes ...

  # WireGuard
  - systemctl enable wg-quick@KubeHive
  - systemctl start wg-quick@KubeHive
  - sleep 10  # tiempo para que el túnel establezca el handshake

  # Join al nodo master con token
  - kubeadm join 10.10.10.10:6443 \
      --token ${kubeadm_token} \
      --discovery-token-ca-cert-hash ${kubeadm_hash}

  # Label para el nodeSelector de los honeypots
  - kubectl --kubeconfig /etc/kubernetes/kubelet.conf \
      label node $(hostname) role=honeypot

  # Filebeat con password oculta
  - filebeat keystore create
  - echo "${filebeat_password}" | filebeat keystore add ES_PASSWORD --stdin --force
  - systemctl enable filebeat
  - systemctl start filebeat
El token que se usa aquí fue generado por Terraform antes de crear el VPS.
Planteamiento de despliegue
Ejecutaremos el siguiente comando:
terraform plan
Veremos que se muestra todo el despliegue que se va a realizar.
Las variables que hemos definido como sensibles se mostrarán así:
user_data = (sensitive value)
kvm = (sensitive value)
default_password = (sensitive value)
Despliegue definitivo
Bien, tras revisar el plan tiene buena pinta. Vamos a desplegar.
terraform apply
Se mostrará el plan
data.external.kubeadm_join: Reading...
data.external.kubeadm_join: Read complete after 2s

Terraform will perform the following actions:

  + vultr_instance.honeypots["mexico"]
  + vultr_instance.honeypots["paris"]
  + vultr_instance.honeypots["svalley"]
  + vultr_ssh_key.kubehive_admin

Plan: 4 to add, 0 to change, 0 to destroy.

Do you want to perform these actions?
  Terraform will perform the actions described above.
  Only 'yes' will be accepted to approve.

  Enter a value:

Indicamos **yes**

Apply complete! Resources: 4 added, 0 changed, 0 destroyed.

Outputs:

honeypot_ips = {
  "mexico"  = { ip = "X.X.X.X", label = "KubeHive-Vader",  region = "mex" }
  "paris"   = { ip = "X.X.X.X", label = "KubeHive-R2D2",   region = "cdg" }
  "svalley" = { ip = "X.X.X.X", label = "KubeHive-SIRIUS",  region = "sjc" }
}
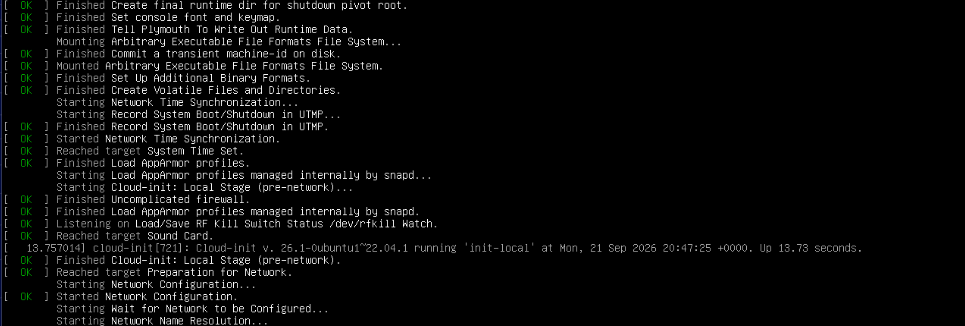
Accederemos a la consola de Vultr y podremos ver la “pantalla” de inicio de las maquinas creadas:
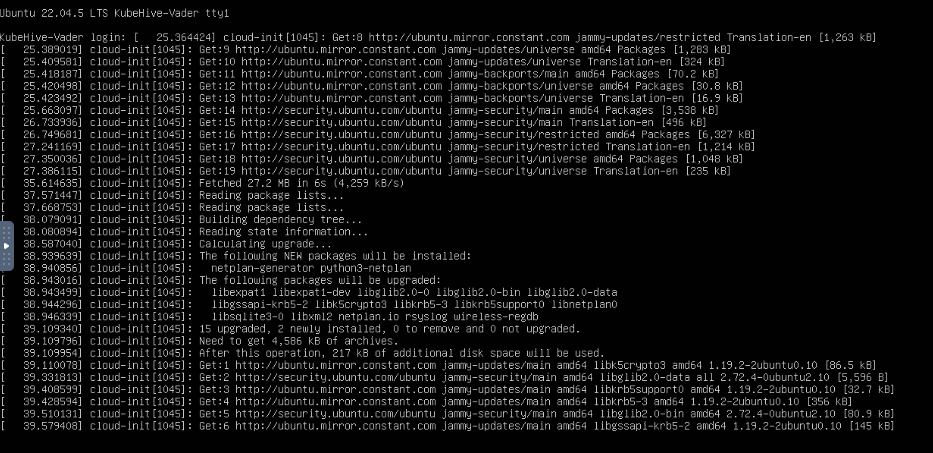
Unos minutos despues del inicio de la VM veremos que cloud-init comienza a instalar paquetes:
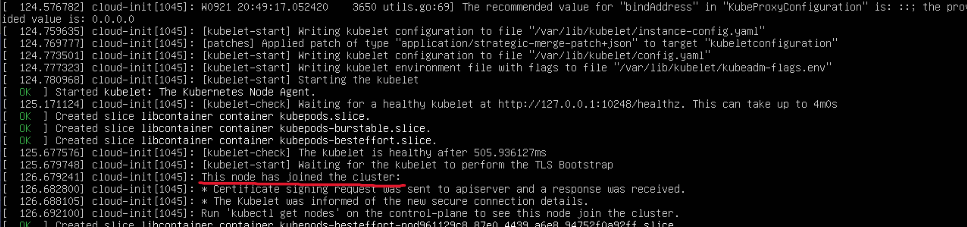
Cuando cloud-init termina veremos que se ha unido el nodo correctamente:
Comprobamos los nodos actuales en el cluster de Kubernetes.
kubectl get nodes -o wide
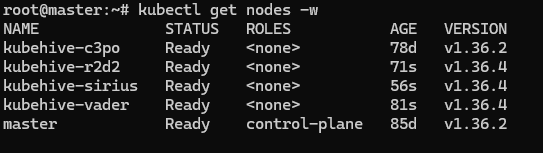
Tres nodos en tres continentes, unidos al cluster, con WireGuard funcionando, Filebeat mandando logs a ELK y listos para recibir honeypots. Sin haber escrito una sola linea ni habernos conectado con SSH.
Parece magia.
Cuando llega el momento de rotar simplemente escribimos:
terraform destroy
terraform apply
Y recibiremos IPs nuevas, mismo setup, mismo cluster. El token se regenera solo y solo tenemos que darle acceso desde nuestro router a WG.
Conclusiones y próximos pasos
Hemos construido la base de un proyecto escalable. Añadir un nodo nuevo es añadir una entrada mas al recuros locals.servers en el main.tf, generar un par de claves WireGuard y hacer apply. Todo lo demás es automático. Es una solución limpia y elegante a la rotación de las direcciones IP. Si tuviera que realizar una actualización no tendría que ir nodo a nodo haciendo “apt update | apt upgrade | apt install “, con añadirlo en el archivo de configuración de los nodos bastaría. Terraform es una herramienta indispensable si vas a administrar infraestructura a gran escala que mantiene un estandart de configuración.
Cosas Pendientes:
Análisis de datos: con nodos en tres regiones se empieza a ver diferencias reales en los patrones de ataque. Los datos de Silicon Valley y México van a ser distintos a los de París. Eso es lo interesante.
Terraform · Vultr · cloud-init · WireGuard · MikroTik RouterOS v7 · Kubernetes v1.36 · Calico · OpenCanary · Mailoney · Filebeat · Elasticsearch 8.x · Kibana
Kubernetes Terraform Cluster Calico Honeypot Cloud Docker WireGuard Elasticsearch Kibana Filebeat
2379 Words
2026-09-17 19:53